"한빛미디어 서평단 <나는리뷰어다> 활동을 위해서 책을 협찬받아 작성된 서평입니다."
부제 : SQLite, PostgreSQL로 직접 만드는 시맨틱 검색과 RAG
AI를 활용한 어플리케이션이 많이 개발되고 있습니다.
클로드, 코덱스의 API를 활용하는 기술을 통해서 개발하고, RAG, MCP 등을 통한
실시간 데이터를 활용한 개념을 도입하려고 할때 항상 나오는 것이 벡터 테이터베이스 입니다.
그러면 기존에 있는 데이터베이스와 어떤 차이를 가지고 있는 것일까요?
벡터에 대한 구조를 저장할 수 있는 데이터 베이스는 무엇이 있고, 기존 일반적인 RDBMS와의 차이는 무엇인지
살펴보고 AI개발시 어떠한 부분을 고려해야 하는지 알아볼수 있는 책입니다.
정확히 알고 벡터 데이터베이스를 사용해야 하는 시점에 필요한 책이 출간 된것 같습니다.
■ 벡터DB란 무엇일까?
· 말을 풀어보면 벡터의 요소를 저장하는 database를 의미합니다. 그러면 벡터의 요소를 어떻게, 어디에 저장이 가능할가요?
책의 부제목처럼, SQLite, PostgreSQL 을 활용해서 데이터를 저장하는 방식을 구성합니다.
우선 우리가 일반적으로 아는 텍스트 형태의 정보말고 벡터의 의미를 정확히 이해해야 할것 같습니다.
그리고 책에서 주로 살펴보것은 왜 AI시대에 벡터DB가 중요하고, 무엇을 해결하기 위해서 벡터 DB를 이시점에 이용해야 하는지
이해하고 어떻게 활용할수 있을지 이해하는 것이 중요할것 같습니다.
· 결국 AI시대에서도 핵심은 데이터 이고, 기술적인 핵심은 임베딩 방식입니다. 이제 이책을 통해서 명확히 이해를 시작해봅니다.
<책의 대상 독자>
- 처음으로 AI 애플리케이션을 구축하는 엔터프라이즈 소프트웨어 개발자
- 의미 기반 검색을 구현하려는 데이터 과학자
- RAG 시스템을 개발하는 머신러닝 엔지니어
- 기존 시스템에 벡터 기능을 추가하려는 백엔드 개발자
<관련 저장소>
- 한국어판 저장소: https://github.com/DualJKorea/VectorDatabaseBook-KO/
- 원서 저장소: https://github.com/nborwankar/VectorDatabaseBook
■ 벡터 DB알아보기 (1장~3장)
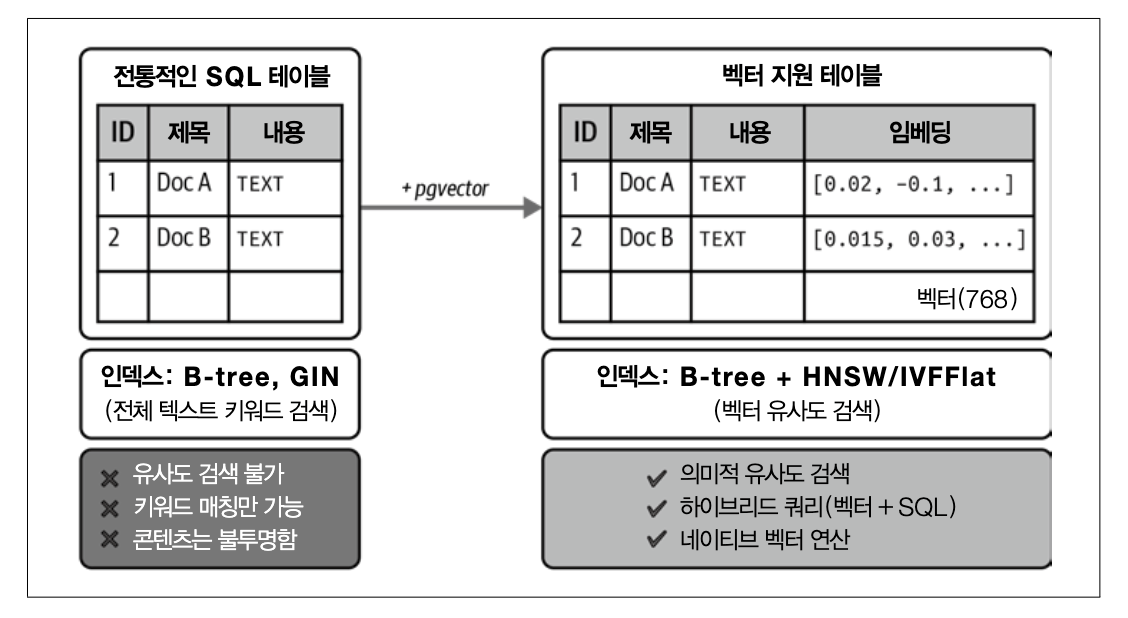
· 기존 방식은 비정형 데이터에 대해서 BLOB으로 저정하거나, 파일에 직접 저장한 뒤 관계형 데이터베이스에서 파일 저장 위치를 가르키는 방식으로 구성했습니다. 저장은 하고 있지만, 효율적으로 사용하기 힘든 구조 입니다.
· 새로운 데이터 타입인 벡터를 구성하고, PostgreSQL에서 확정 시스템 타입을 새로 추가해서, pgvector확장이 VECTOR타입 컬럼을 생성하는 기능을 제공합니다.
· 유사도 검색기능
단순히 정렬된 부동 소수점 수의 집합을 저장하고 조회하는 방식에서 VECTOR타입을 구별해 주는 핵심 요소입니다.
이 기능 덕분에 주어진 텍스트와 의미상 유사한 텍스트를 찾을수 있습니다.
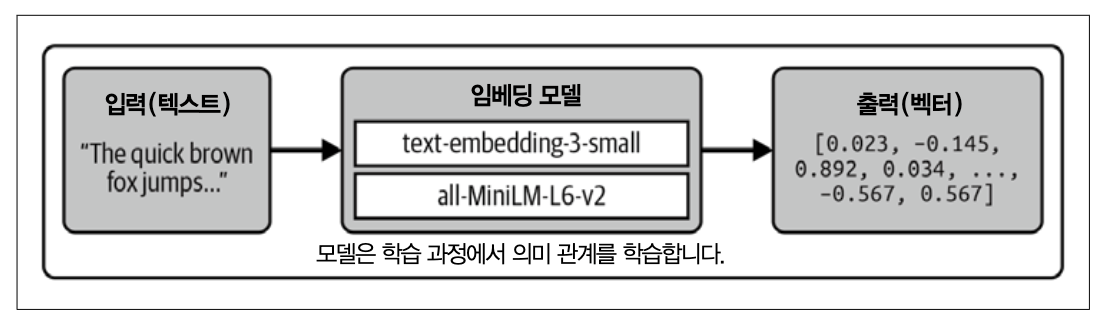
· 임베딩에 대해서
구조화되지 않은 데이터를 청크 단위로 나누어 백터, 부동소수점 수 목록으로 매핑하는 과정입니다.
이러한 매핑은 단어나 문장이 사용된 문맥을 보존합니다. 의미가 가까까운 단어들은 벡터 공간에서 서로 가까운 위치의
벡터로 매핑됩니다.
3장에서 임베딩에 대해서 더욱 구체적으로 다룹니다. 그것을 이해해야지 벡터DB를 더 잘 활용할수가 있습니다.
Word2Vec를 통해서 기술적인 활용도가 높아진 벡터의 동작원리를 파악하고, 오늘날까지 기술의 혁신이 된 부분을 확인합니다.
Doc2Vec을 통해서 단어에서 문서를 활용하기 위한 방식, 희소 임베딩, 밀집 임베딩을 살펴보고
Word2Vec와 Doc2Vec이 정적 벡터 표현을 제공했다면, 현대 LLM의 핵심인 트랜스포머 아키텍처를 통해서 대규모 동적으로 조작하고 생성합니다.
BERT와 같은 인코더 전용 트랜스포머, GPT계열의 디코더 전용 트랜스포머에 대해서 설명하면서 기본적으로 딥러닝 내용에서 언급하고 설명할 사항일 벡터DB가 왜 필요할지, 우리는 어떻게 활용해야 할지 이해할수 있습니다.
· 최근접 이웃검색 등 벡터DB가 어떻게 검색되고 동작하는지 원리를 살펴봅니다.

· 기존 RDBM에서 처리하기 힘든 부분과 차이점, NO-SQL을 통해서 해결시도 등에 대해서 다룹니다.
NO-SQL을 통해서도 시도는 해보았지만, 벡터정보를 처리하기 하기에는 어려움이 있습니다.
· RAG 파이프라인
- 기본 python코드로 구성 및 sentence-transformers 라이브러리를 이용해서 구현 실습합니다.
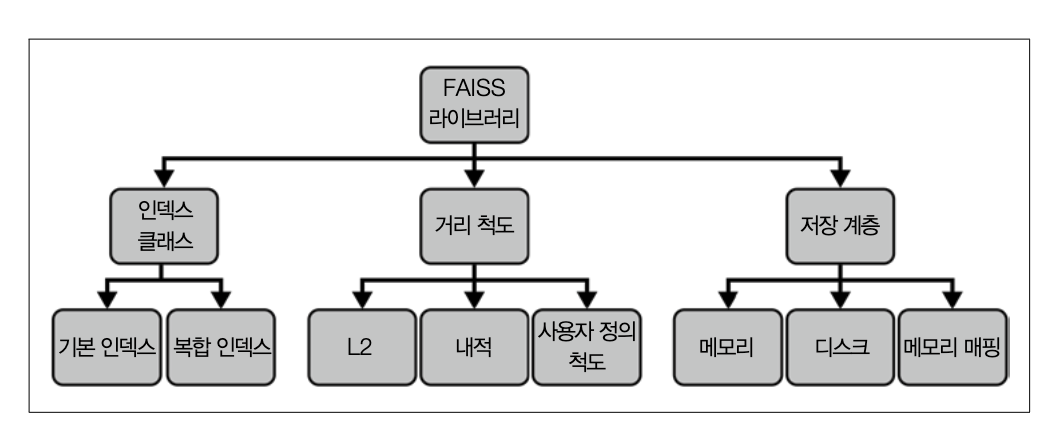
· FAISS(Facebook AI Similarity Search)는 대규모 고차원 밀집 벡터(dense vector)의 유사도 검색과 클러스터링을 아주 빠르게 처리하기 위해 페이스북에서 개발한 오픈소스 라이브러리입니다.
https://github.com/facebookresearch/faiss
GitHub - facebookresearch/faiss: A library for efficient similarity search and clustering of dense vectors.
A library for efficient similarity search and clustering of dense vectors. - facebookresearch/faiss
github.com
FAISS를 이용해서 벡터DB를 실습하고 연습합니다.
오픈소스 아키텍처를 하나하나 살펴보고, 동작 원리를 살펴봅니다.
벡터구성을 어떤 식으로 알고리즘 적용하는 것을 하나하나 분석합니다.
- Index (추상 기반 클래스)
- IndexFlat
- IndexIVF (역파일 색인)
- IndexPQ
- IndexIVFPQ
- IndexHNSW
- IndexBinary
■ SQLite3와 PostgreSQL을 사용한 어플리케이션 구축 (4장~8장)
· SQLite를 이용해서 SQL인터페이스와 벡터유사도 검색을 결합해 키워드가 아니라 의미를 기준으로 검색하는 방법을 파악합니다.
FAISS를 래핑한 SQLite확정인 sqlite-vss를 사용해서 벡터 검색을 관계형 데이터베이스 환경에 통합합니다.

· 개발환경을 구성해서 코드적으로 실습을 진행하게 구성되어 있습니다.

- DB생성을 통한 테이블 구성을 진행하고, 스카마 설계를 결정 합니다.
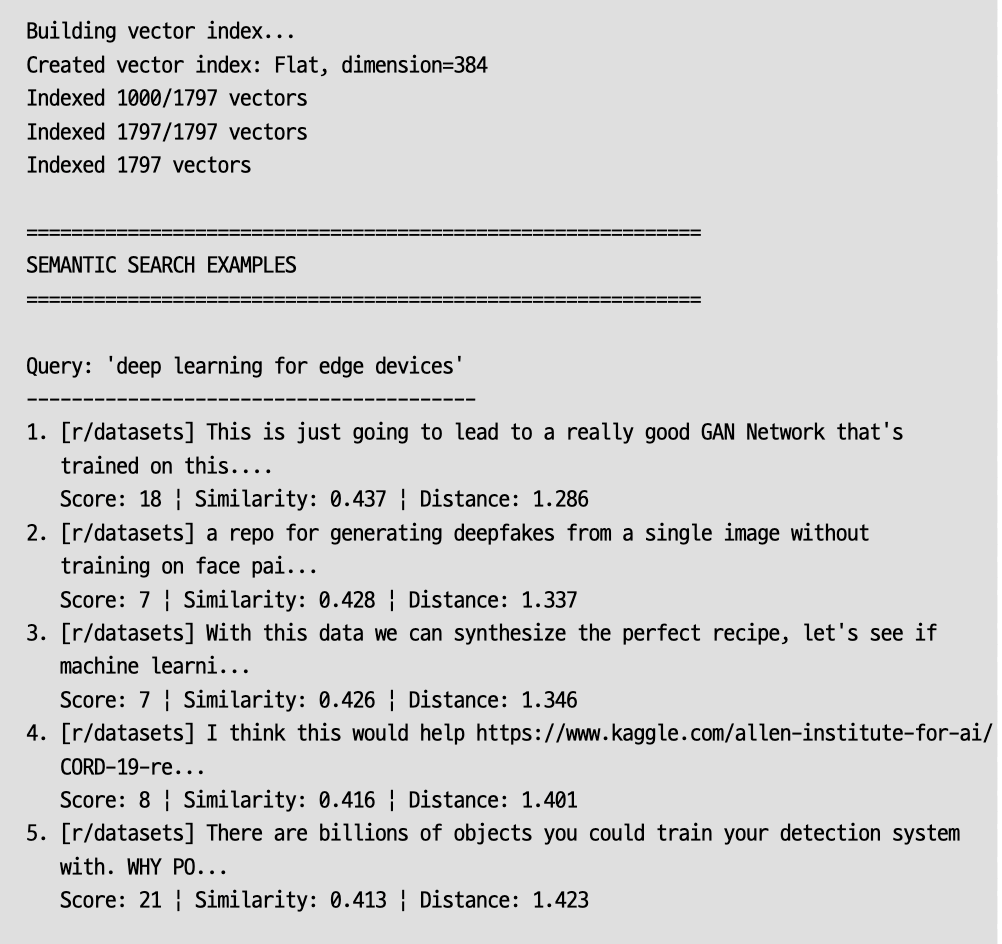
- 데이터 구성은 캐글 레딧 댓글 데이터셋에서 로컬 지식 베이스용 레코드 추출하여서 CSV파일을 로컬 데이터 소스로 활용합니다.
실제 예제를 동작시키면서, 의미기반 검색을 동작시켜 봅니다.
· PostgreSQL pgvector로 arXiv 논문 검색 시스템 구축하기
· SQLite VSS와 Ollama로 검색 증강 생성 시스템 구축하기
· PostgreSQL과 pgvector로 과학 논문 RAG 시스템 구축하기
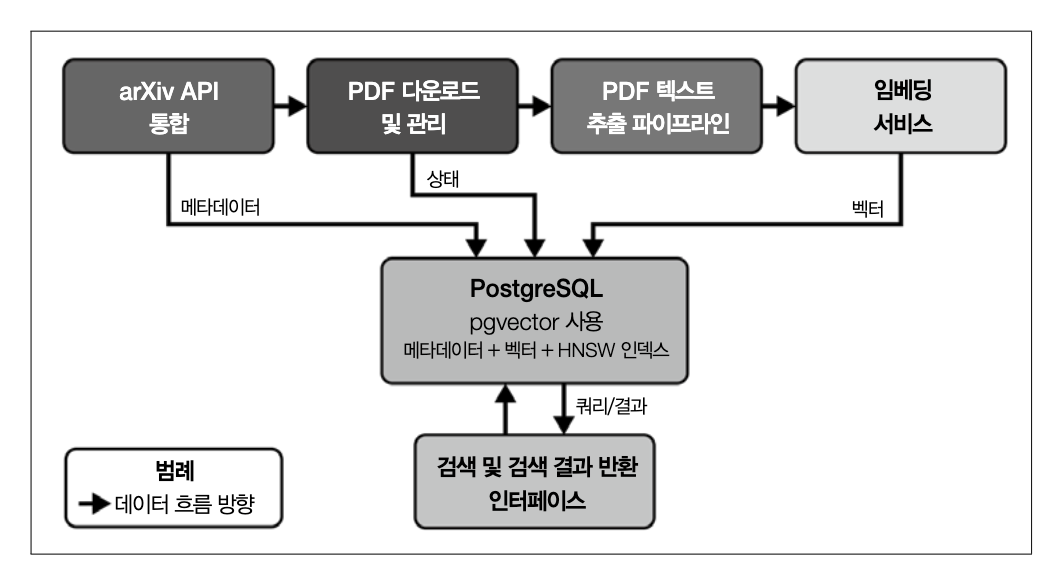
· PostgreSQL을 통해서는 pgvector를 활용하여서 arXiv 논문검색 및 과학논문 RAG 시스템을 구축합니다.
- 시스템 구성 아키텍처는 아래와 같습니다.
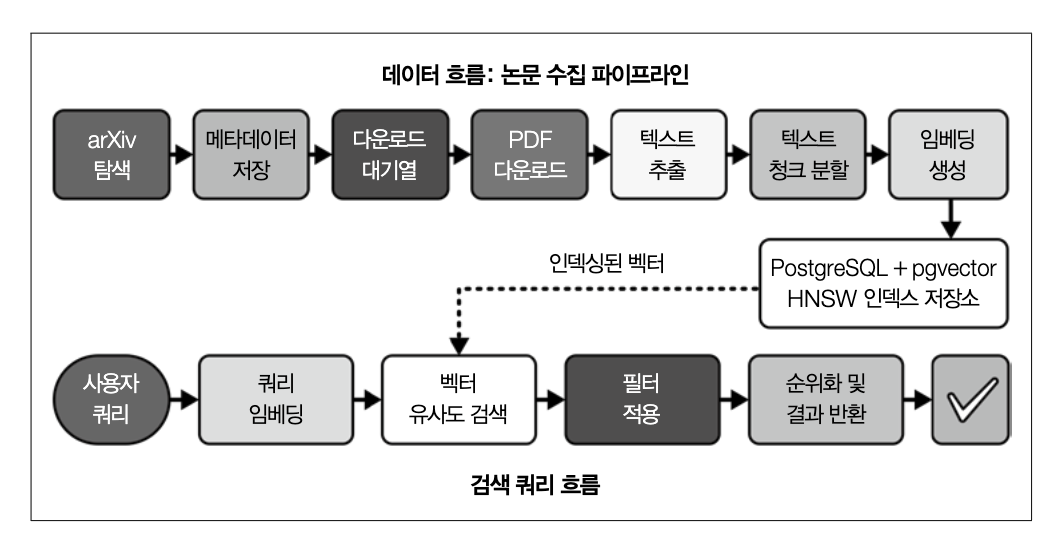
- 세부적인 데이터의 흐름도는 아래와 같습니다.
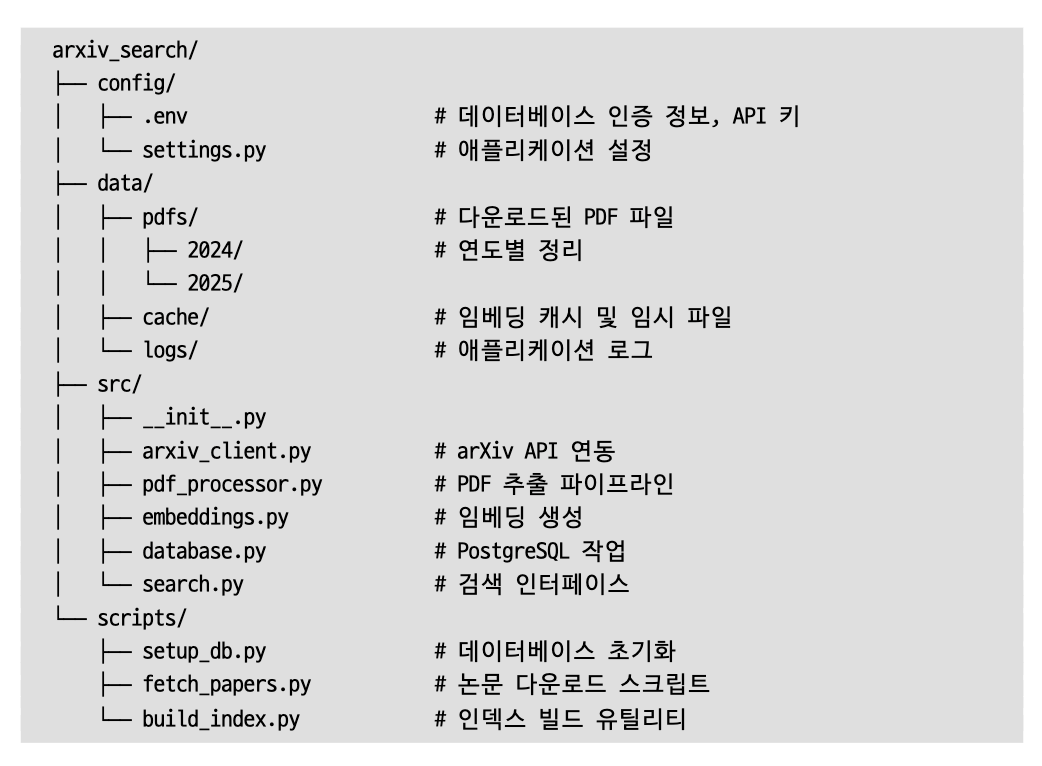
- 디렉토리 구성은 아래와 같이 개발을 진행합니다.
엔티티구성을 통한 데이터베이스 설계를 진행하고, 벡터 저장 및 인덱싱 전략을 적용합니다.
PDF의 텍스트를 추출하고 처리합니다.
임베딩 생성 및 저장을 통해서, 유사도 구현까지 진행을 진행합니다.
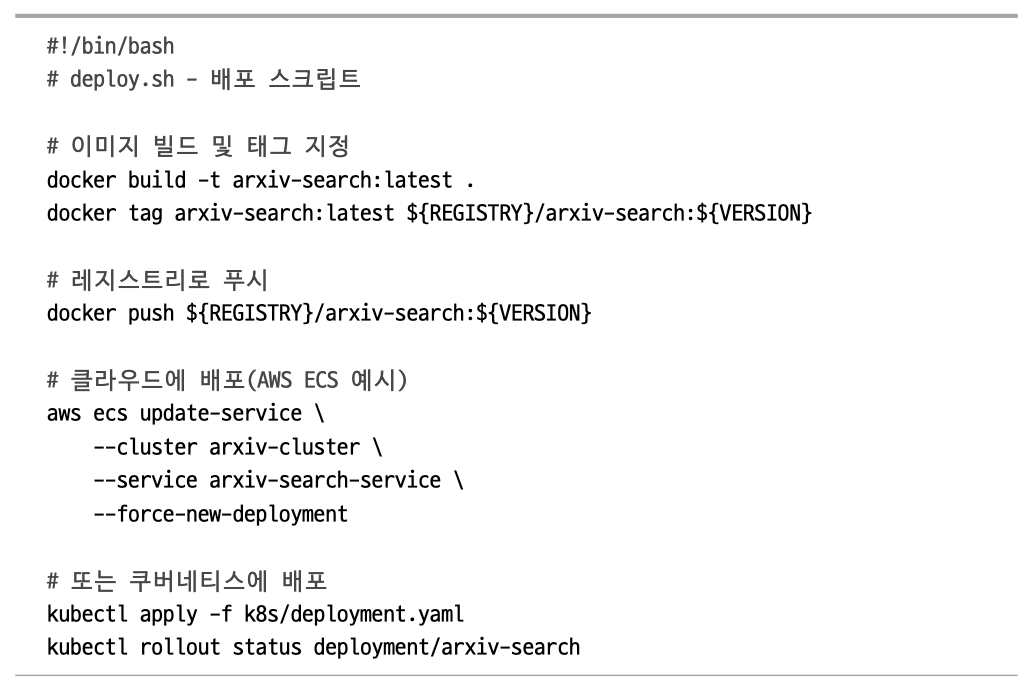
배포에 대한 부분도 도커 / ks8을 통해서 실제 서비스 구현 레벨까지 구현합니다.
· SQLite을 통해서 VSS와 Ollama을 이용해서 검색 증강 생성 시스템을 구축해봅니다.
- 테스트용 로컬 LLM 실행 환경으로 Ollama을 이용합니다.
Ollama
Ollama is the easiest way to automate your work using open models, while keeping your data safe.
ollama.com
RAG용 스키마 생성 후, 검색 인덱싱 생성을 효율적으로 진행하기 위해서 2가지 생성합니다.
임베딩을 사용한 컨텐츠를 저장하고, Ollama API를 연동합니다.
이것을 통해서 RAG 파이프라인을 구축합니다. 모든 구성요소가 하나로 이어집니다.
'book' 카테고리의 다른 글
| 클로드 에이전트 협업의 기술 (0) | 2026.08.23 |
|---|---|
| 코딩 자율학습 FastAPI 파이썬 백엔드 개발 입문 (0) | 2026.08.01 |
| 클로드 올인원 with 코워크, 코드, 디자인 (0) | 2026.07.25 |
| 원하는 대로 튜닝하는 나만의 sLLM (1) | 2026.07.19 |
| 이것이 멀티 에이전트다 (0) | 2026.06.26 |
